OpenAI Image 2.5一致性狠到能做动图?能,但不稳定


OpenAI 最新发布的 GPT-Image 2.5 模型,最大的亮点,应该就是极稳定的一致性了。
它可以正确和精确执行用户的编辑需求,又不会带来额外的变化、画面漂移或是抖动。
因此,脑洞大开的网友发明出了一种邪修玩法,用 ChatGPT Work( 或 Codex )结合 GPT-Image 2.5,一次性生成多张图片用作视频帧,来做 gif 动图。
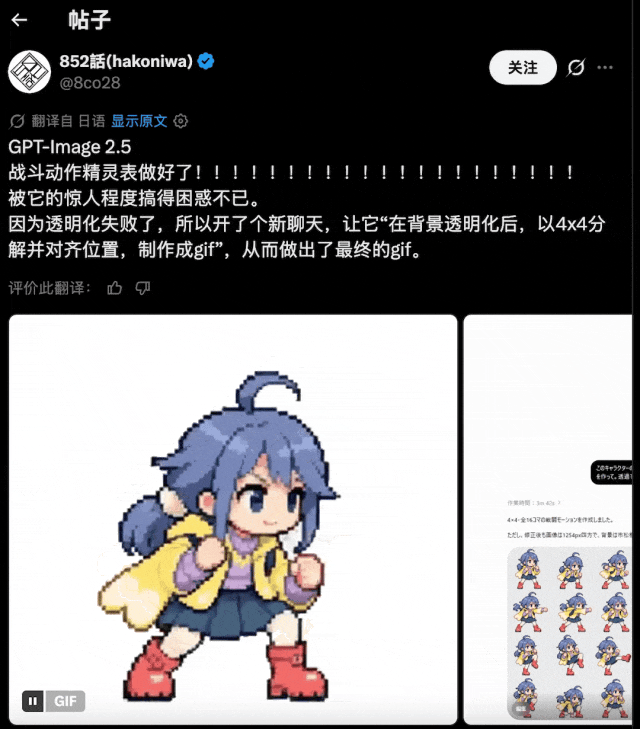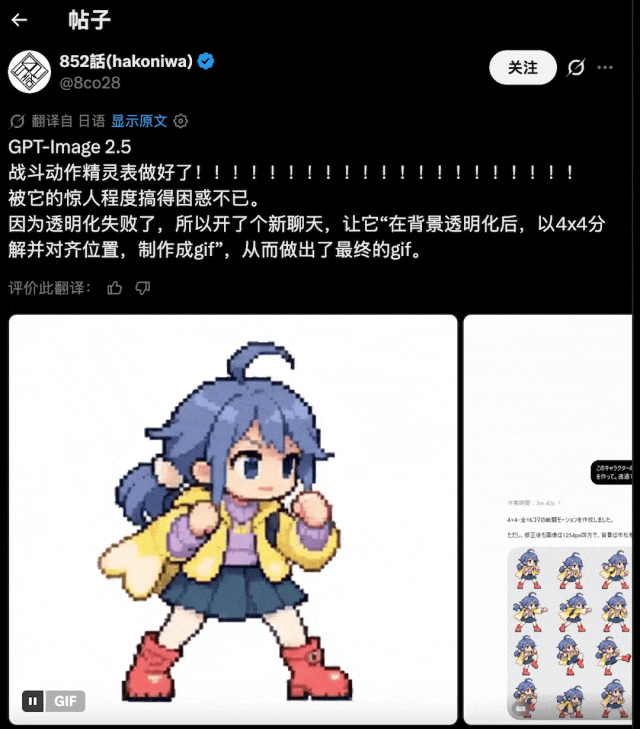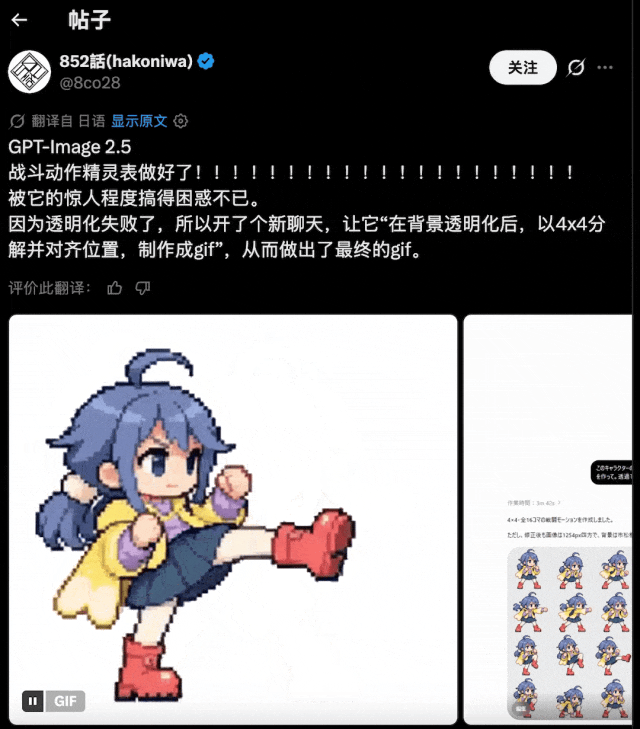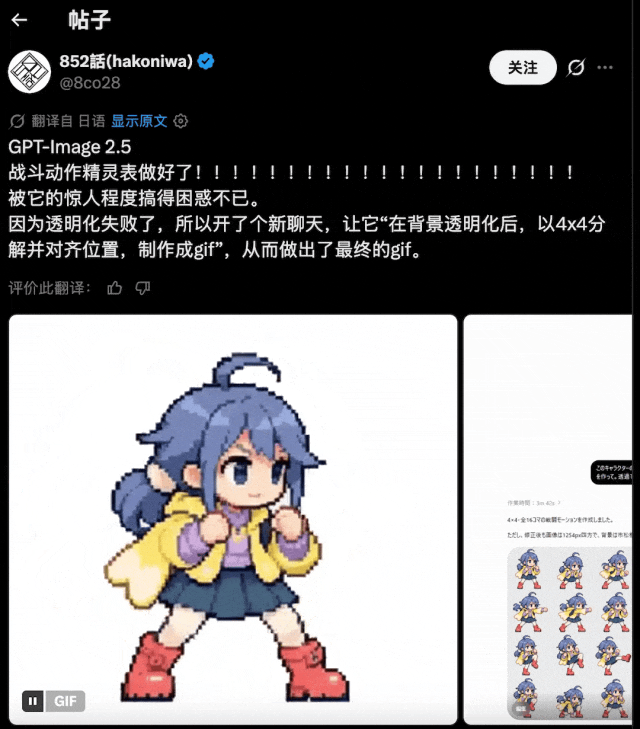
来源:https://x.com/8co28/status/2097423580229521849
要做出这种 gif 动图,一般是让 GPT-Image 2.5 生成一张图片,里面包含所有 16 帧镜头按 4×4 阵列排布,然后让 ChatGPT Work 将单张图切分成 16 张,再合成 gif 文件,在制作过程中,如果 ChatGPT Work 发现生成内容有偏差,还会进行修改。
还有一些更极致和烧 token 的做法,是每一帧画面都来自独立生成的图片,比如 Higgsfield 展示的这个案例,左边是 GPT-Image 2 生成的,可以看到明显的画面漂移,右边是 GPT-Image 2.5 生成的,已经丝滑到了视频级甚至实拍级的程度。
来源:https://x.com/higgsfield/status/2097555699832443050
GPT-Image 2.5 的这种级别的稳定性能升级很多商业场景的体验,比如营销图片的微调,甚至能解锁给视频修帧的场景,也能极大减少对 PS 等专业软件的依赖。
当然,本着 “ 测评就是找茬 ” 的精神,知危还是打算探一探 GPT-Image 2.5 在 gif 这个邪修玩法下,能厉害到什么程度,或者在什么情况下会翻车。
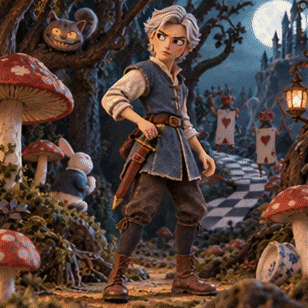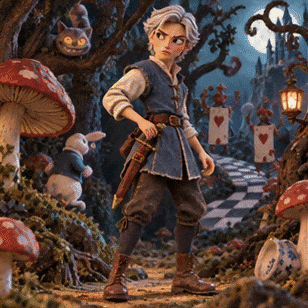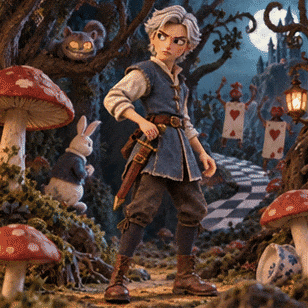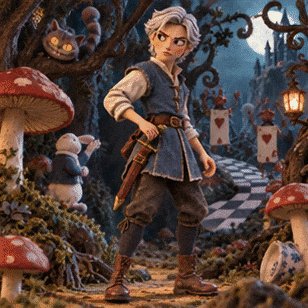
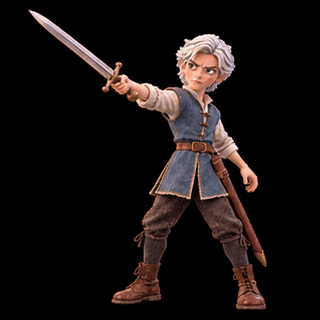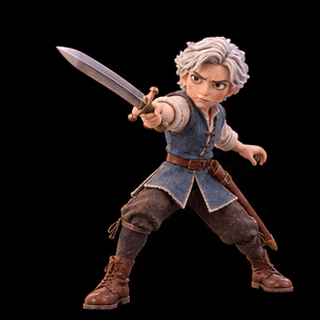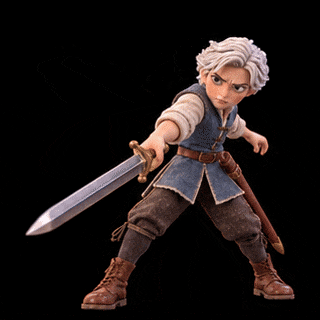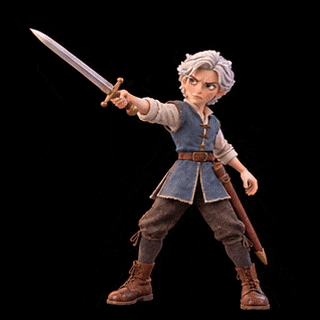
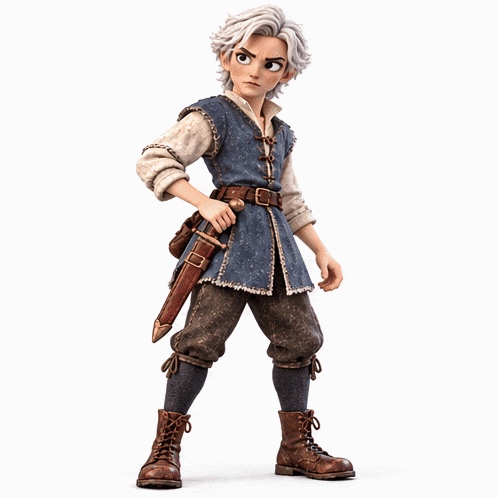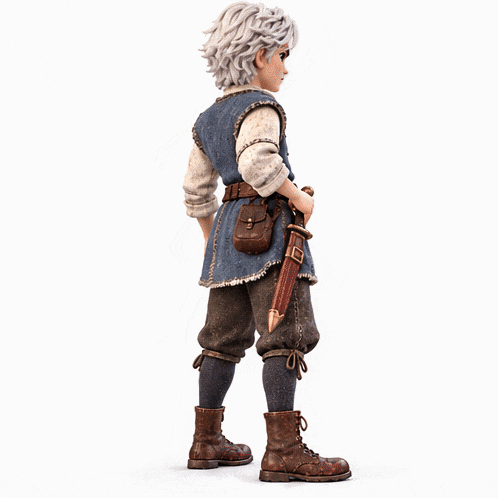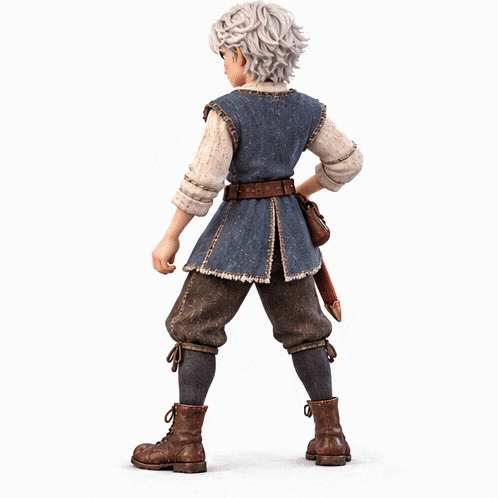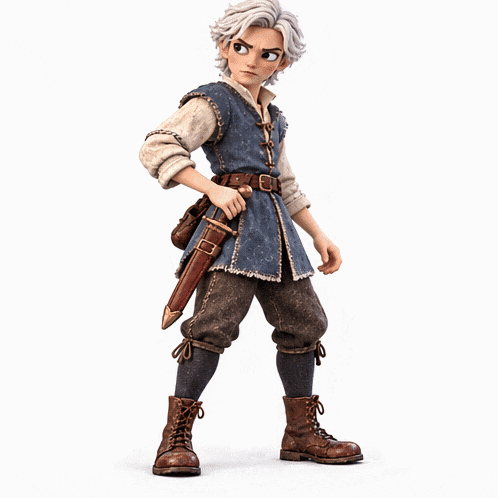
我们会以一个人物作为主体,如下图,是仿照《爱丽丝漫游仙境》的元素画出来的粘土风格持剑少年。
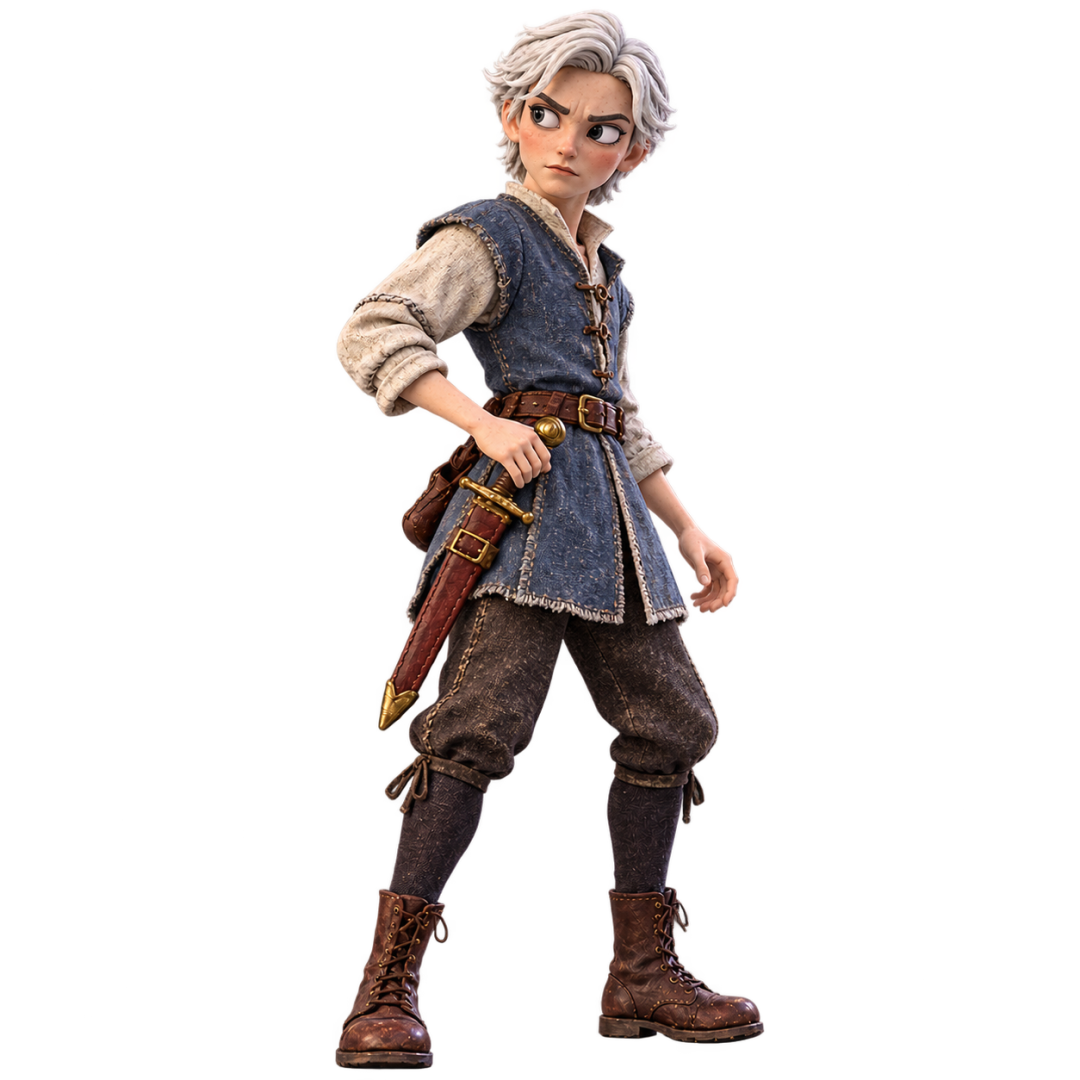
测试场景分为两类,基础类和极限类。基础类包括动作、运镜、环境和空间、物理等类型,极限类是指模仿 Higgsfield 的案例来一个终极考验——变形金刚变身。
注意:在 ChatGPT Work 这个环境下,暂时无法确认使用的是基础的 Sunburst 模型,还是更具性价比的 Flare 模型。后面会提到,即便明确用 GPT-Image 2.5 Sunburst Max,也不能保证结果是完美的。
首先是基础类测试中的动作类型,会包含三个场景:
- 简单踢腿动作;
- 主体自身静止并旋转 360 度;
- 两个主体的简单动作;
先来一个最简单的,让少年做一个踢腿动作,ChatGPT Work 里调用的大语言模型是 GPT-6 Astra ( 思考强度:high )。
提示词:
为我生成图中角色的定格动画风格的 GIF 表情包每一帧的图片。
具体而言,先生成一张图片后,再切分成一张张正方形的小图,切分时尽量切掉更多的空白,然后合成 GIF 动图。
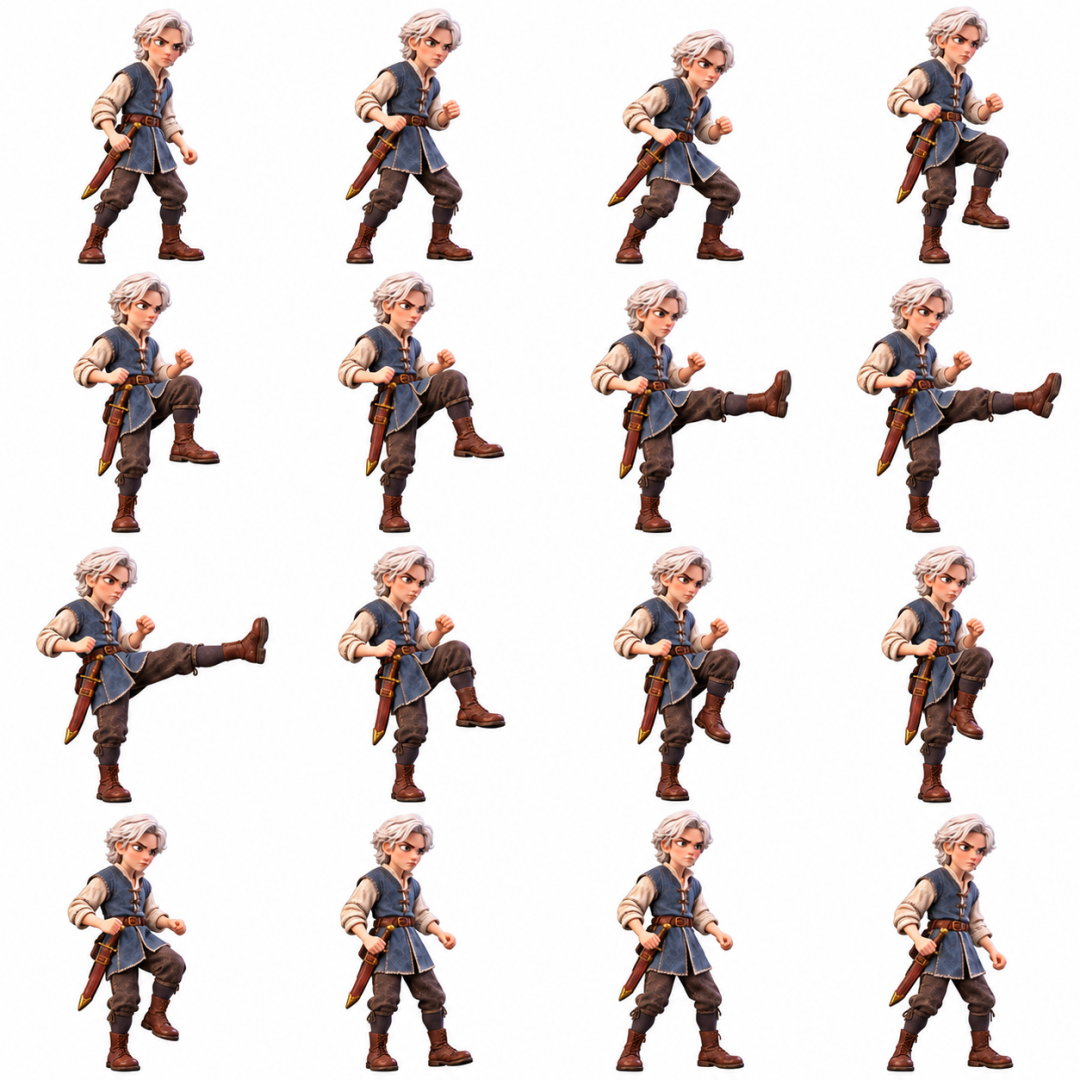
使用 4 行 x4 列 布局在一张图中共生成 16 个小图片。16 个小图片呈现连贯的踢腿、收腿动作,使用这 16 张可以组成一个完整的、循环动画,动作流畅逼真,最后一帧应流畅地循环回到第一帧。
每张小图片的主体都不要超出所在小图片的画面区域。
生成结果如下,可以看到生成的踢腿动作还是很流畅的,也正确衔接回了第一帧形成了循环动画,主体各部分画面细节都没有出现随机漂移,跟网友分享的案例质量接近。
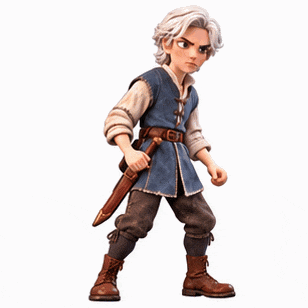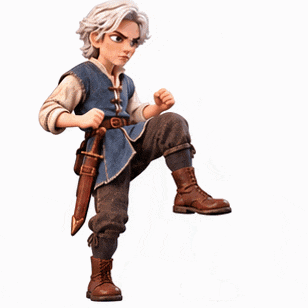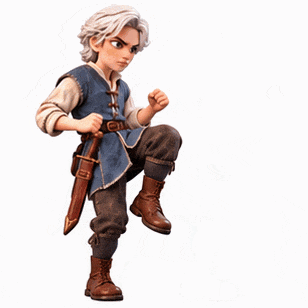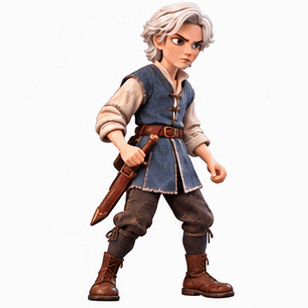
下图是裁切前的完整图像,包含了所有 16 个动作,也看不出有什么问题。
但如果把这个踢腿动作再复杂化,增加拔剑、挥砍动作,并把图片数增加到 48 张 ( 3 张原图,每张画 16 帧镜头 ),问题就出现了。
提示词:
为我生成图中角色的定格动画风格的 GIF 表情包每一帧的图片。
具体而言,先生成一张图片后,再切分成一张张正方形的小图,切分时尽量切掉更多的空白,然后合成 GIF 动图。
使用 4 行 x4 列 布局在一张图中共生成 16 张小图片,总共生成 3 张大图,切分成 48 张小图片,每张大图最后一张小图承接下一张大图第一张小图的内容。48 张小图片呈现主体连贯的侧踢腿、收腿、拔剑、挥砍的动作。使用这 48 张可以组成一个完整的、循环动画,动作流畅逼真,最后一帧应流畅地循环回到第一帧。
每张小图片的主体都不要超出所在小图片的画面区域。
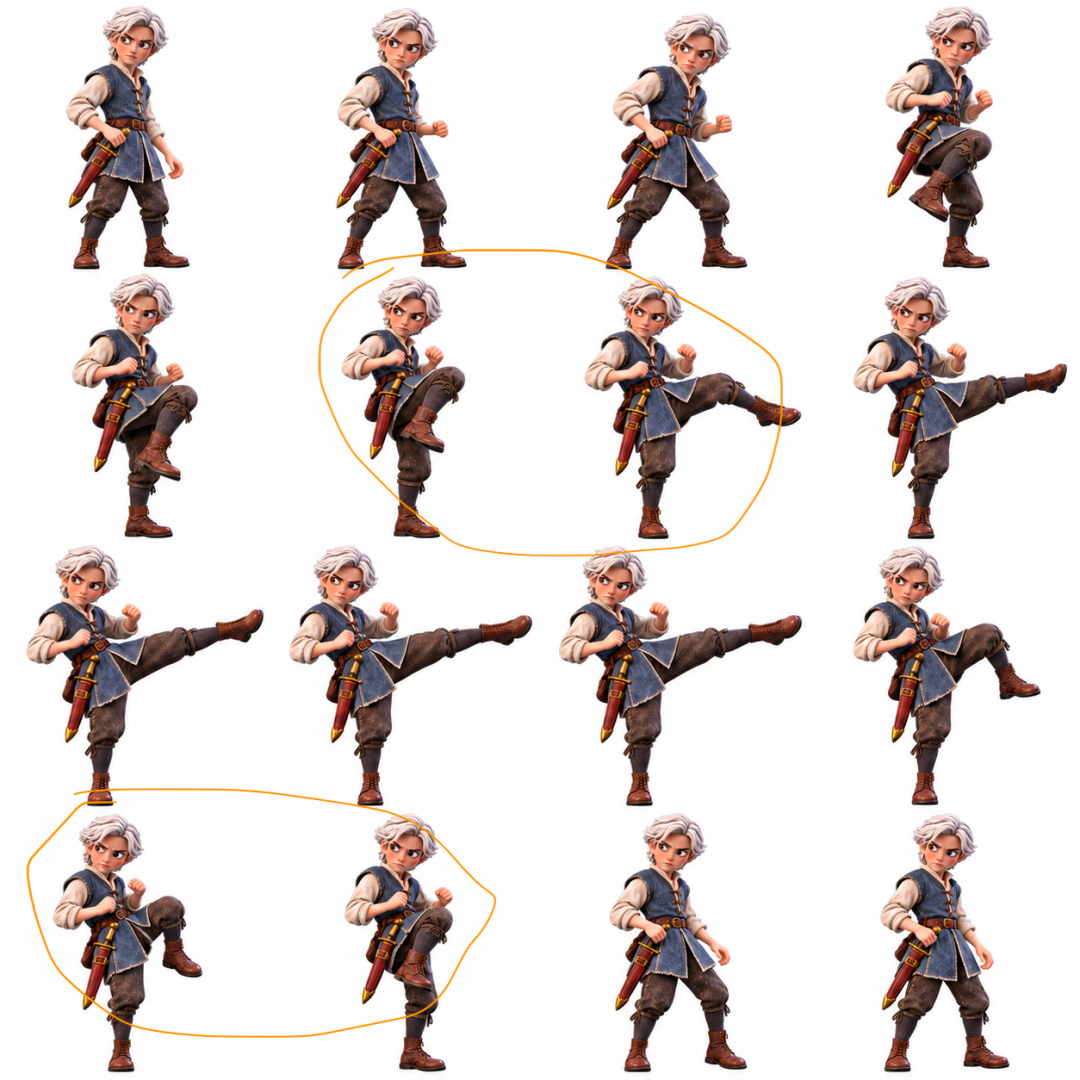
生成结果如下,人物开始有比较明显的随机抖动。并且,可以明显地感受到,它还是容易犯图像生成模型经常犯的错误,也就是对非标准条件的错误处理。乍一看踢腿动作没问题,但拔剑和入鞘动作就有很明显的错误,毕竟这个姿势确实不是常规的拔剑预备姿势。
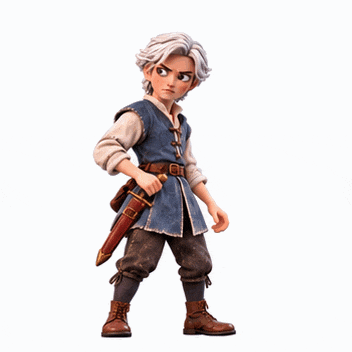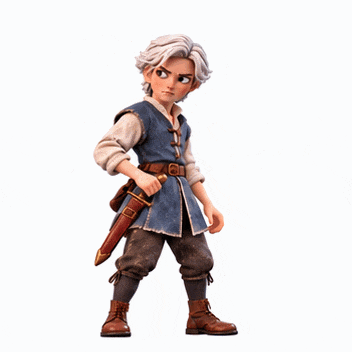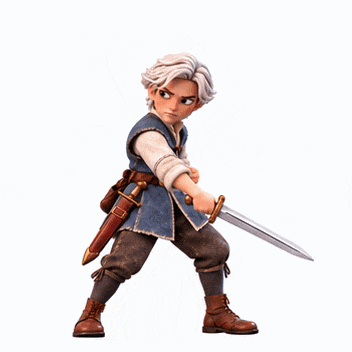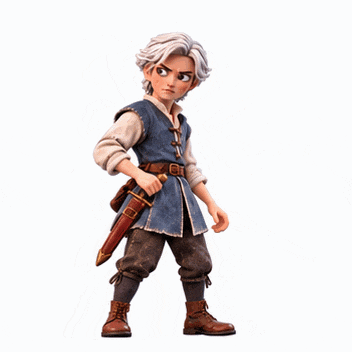
再来看下图具体的帧分解,就能发现另一个常见的错误,也就是人体的生物准确性错误,第 6 帧和第 7 帧之间出现了右腿换左腿的错误,第 13 帧和第 14 帧又反过来。
再来看看下一个场景,也就是 “ 主体自身静止并旋转 360 度 ” 场景下,会是什么效果。
生成结果如下,旋转动态并不是匀速的,视觉观感上也不丝滑,后半部分从侧身旋转回正面的时候有快速跳变,再观察脚部的旋转过程会有更明显的感受,头部有些微摆动,但至少头发这种复杂度极高的对象基本保持了一致。
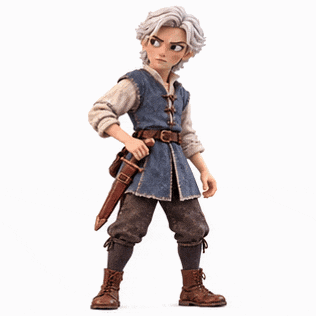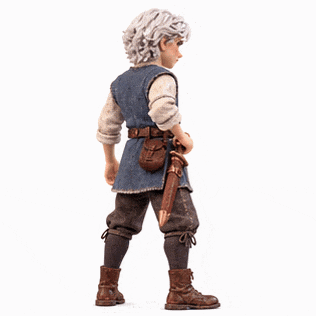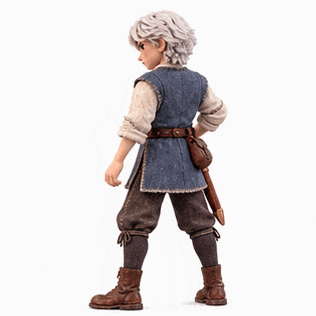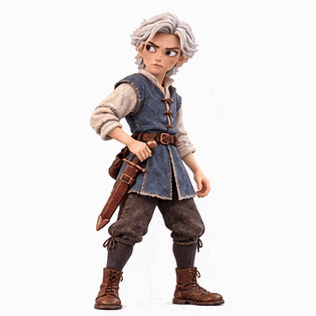
但总体来说,画面稳定性还是比较强的。至于跳变可能也难以避免,毕竟只有 16 张图片,还是裁切出来的低像素图,而上述 Higgsfield 的案例用了 60 张高清图来呈现这个过程。
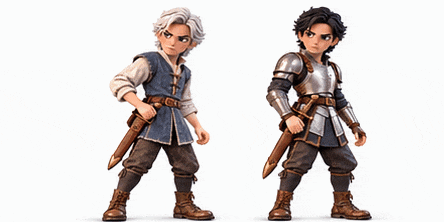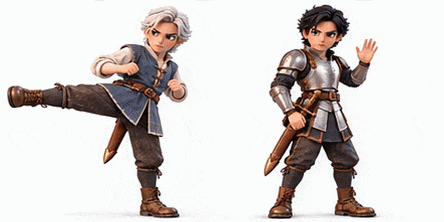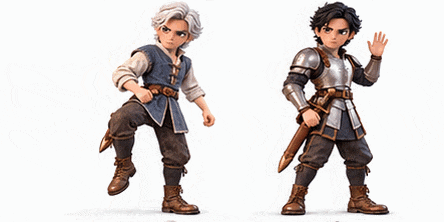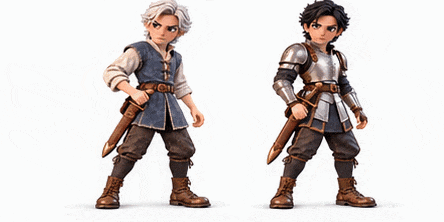
接下来是动作类型的最后一个场景 “ 两个主体的简单动作 ”,这里需要对参考图片做一个修改,在右边增加一个微调过外观的持剑少年。
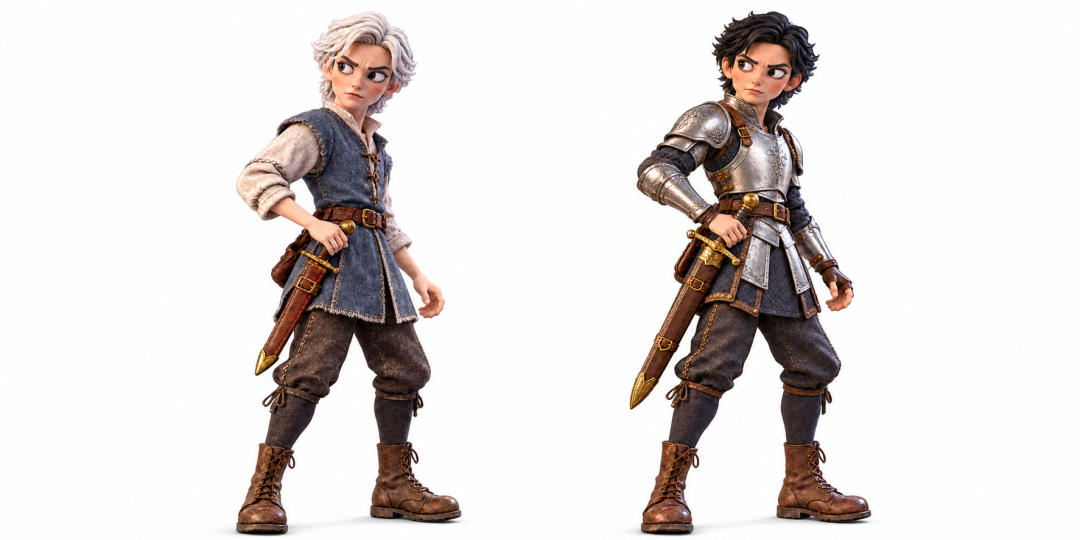
然后让他们做不一样的动作,左边的少年做踢腿动作,右边的少年做挥手动作。生成结果如下,出现了很明显的画面漂移,特别是水平方向上,看来同时处理两个主体确实增加了控制的难度。
接下来是基础类测试中的第二种也就是运镜类类型,包含两个场景:
- 镜头拉远和推近;
- 垂直环绕运镜;
第一个场景完成的不错,也不令人意外。
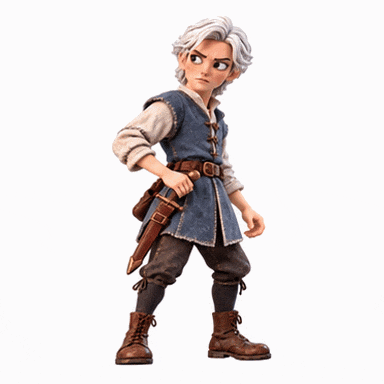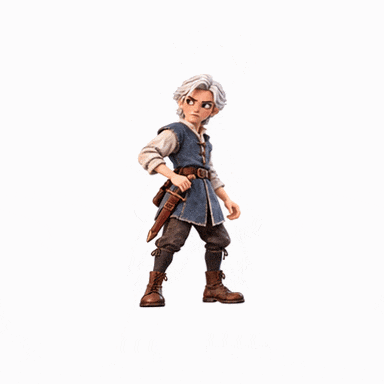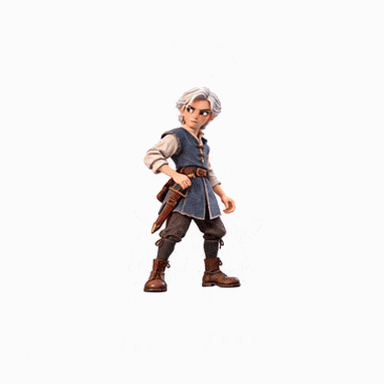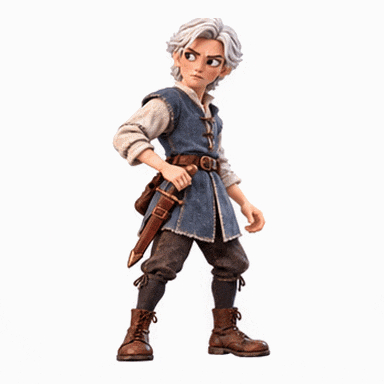
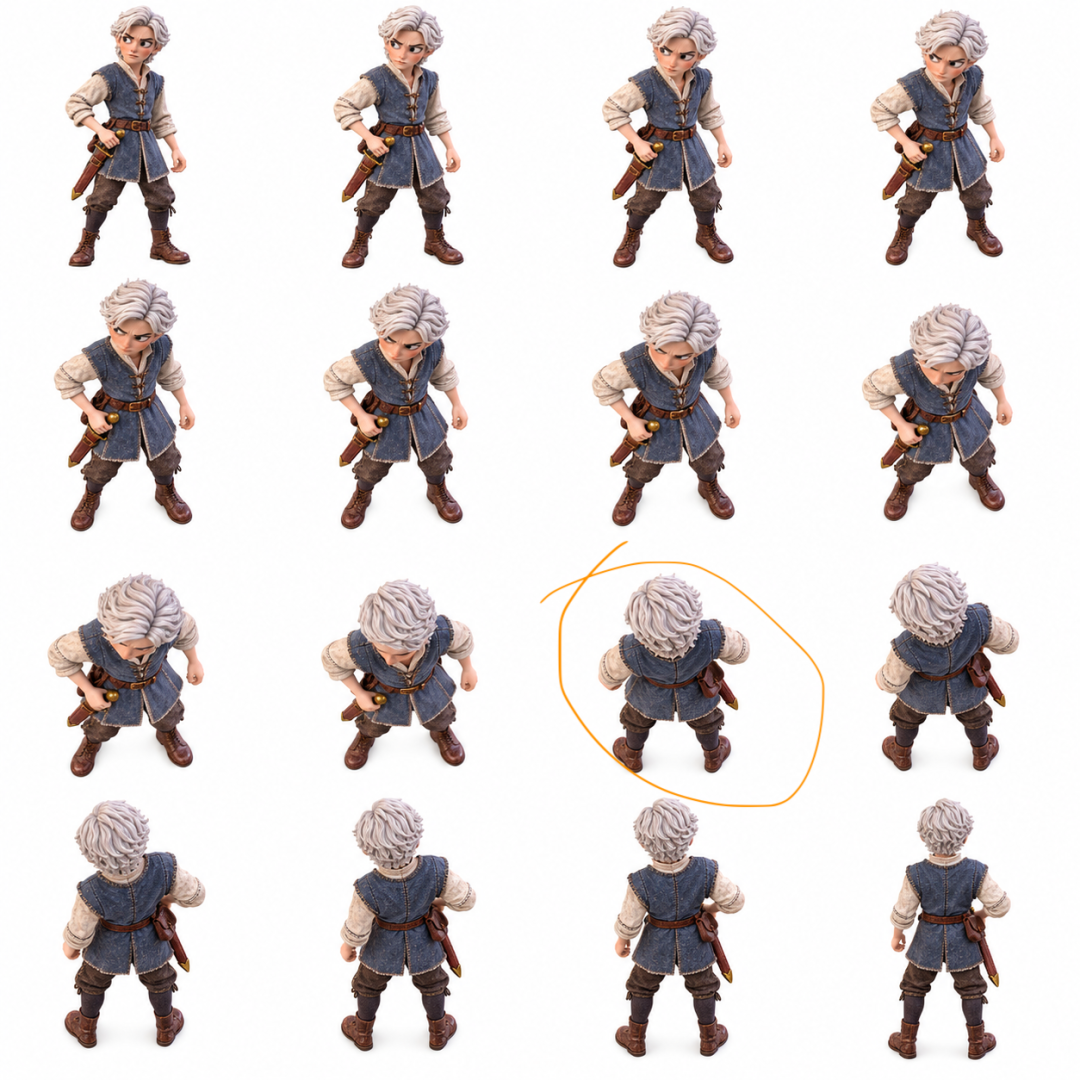
在第二个场景中,模型在处理从头顶绕到背后的时间节点的镜头时,出现了突兀的跳变,相当于让主体先旋转了 180 度再去拍摄他的背面。
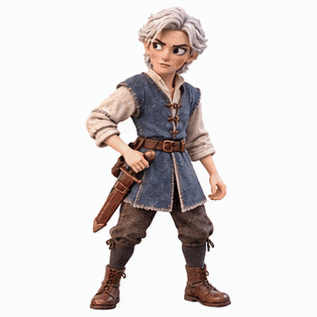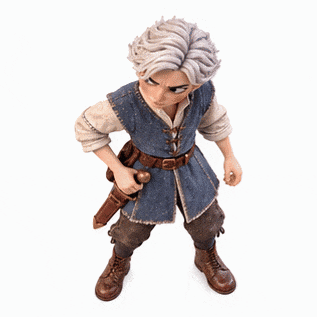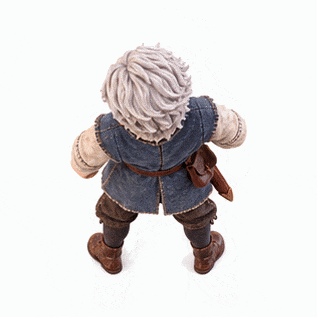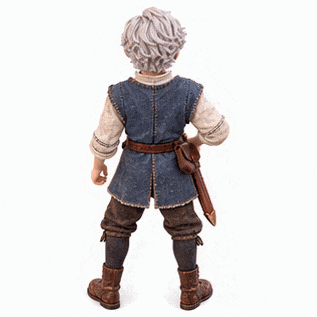
在帧分解图中,可以看到是在处理第 11 帧的时候出现了跳变,这个节点确实也是相机拍摄中很少出现的机位,所以处理的不太好。实际上,模型采用了正确的拍摄角度,但把相机的上下位进行了翻转,造成了突变的效果。
但接下来的基础类测试的第三种也就是环境和空间类型会更难,这其中包含三个场景:
- 背景变化;
- 空间透视处理;
- 穿透三维空间;
在背景变化测试中,我们先把少年放入爱丽丝式仙境的背景中,然后让少年保持静止,背景中的蘑菇、树木、猫猫、兔子、扑克牌持续跳舞。
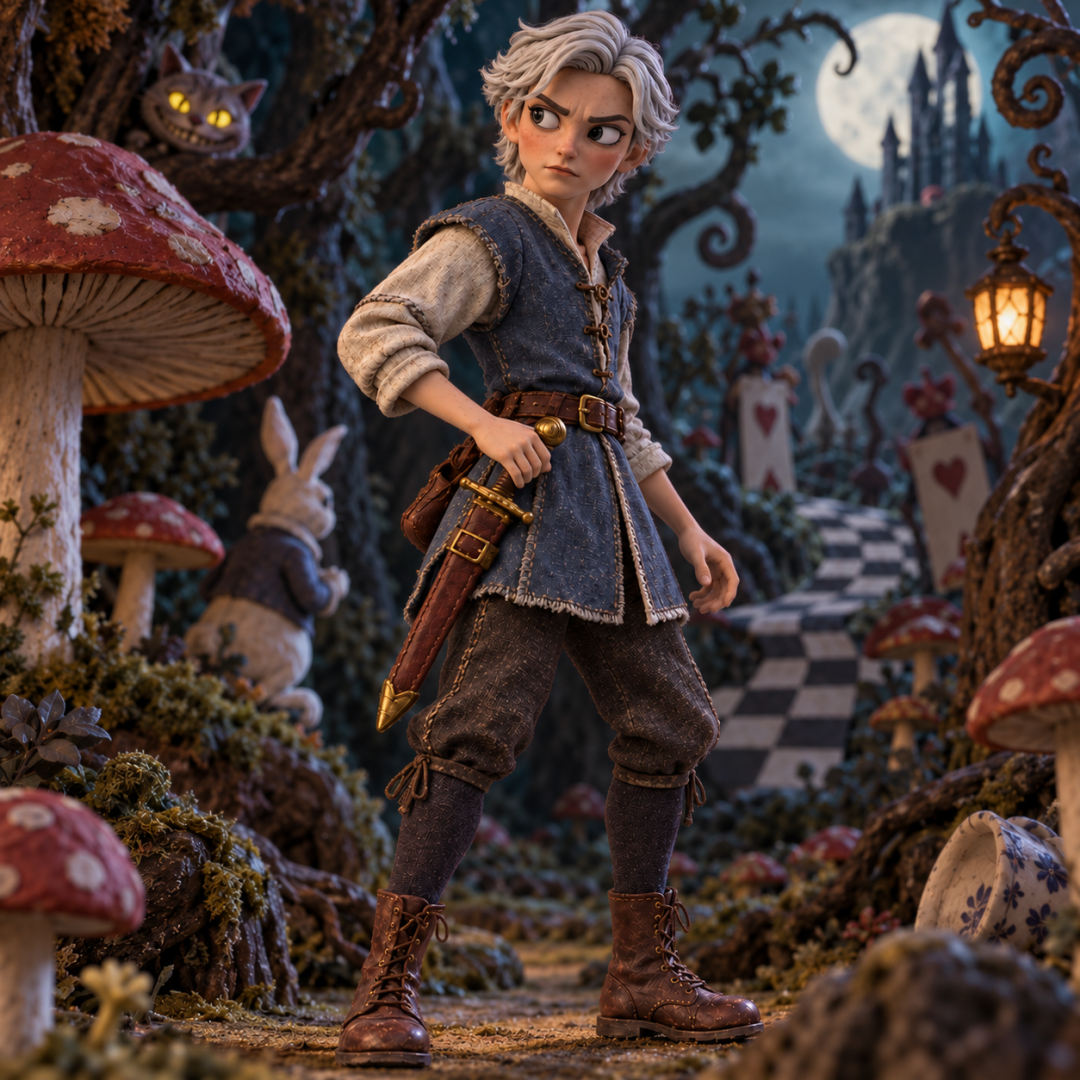
生成结果如下,这种设置其实类似前面处理两个主体条件下的情况,可以看到不参与跳舞的其它对象,特别是山体、城堡、月亮、树木等都无法保持静止不动。
接下来测试一下空间透视处理场景,让少年持剑挥向镜头,这时剑末端离镜头非常近,就会有明显的空间透视效应。
生成结果如下,对剑的透视处理确实做的挺好的,但画面的随机抖动变多了,持剑手的生物准确性有明显的错误,腿部的前后脚做了一致的放大,不符合空间透视中近大远小的原则。
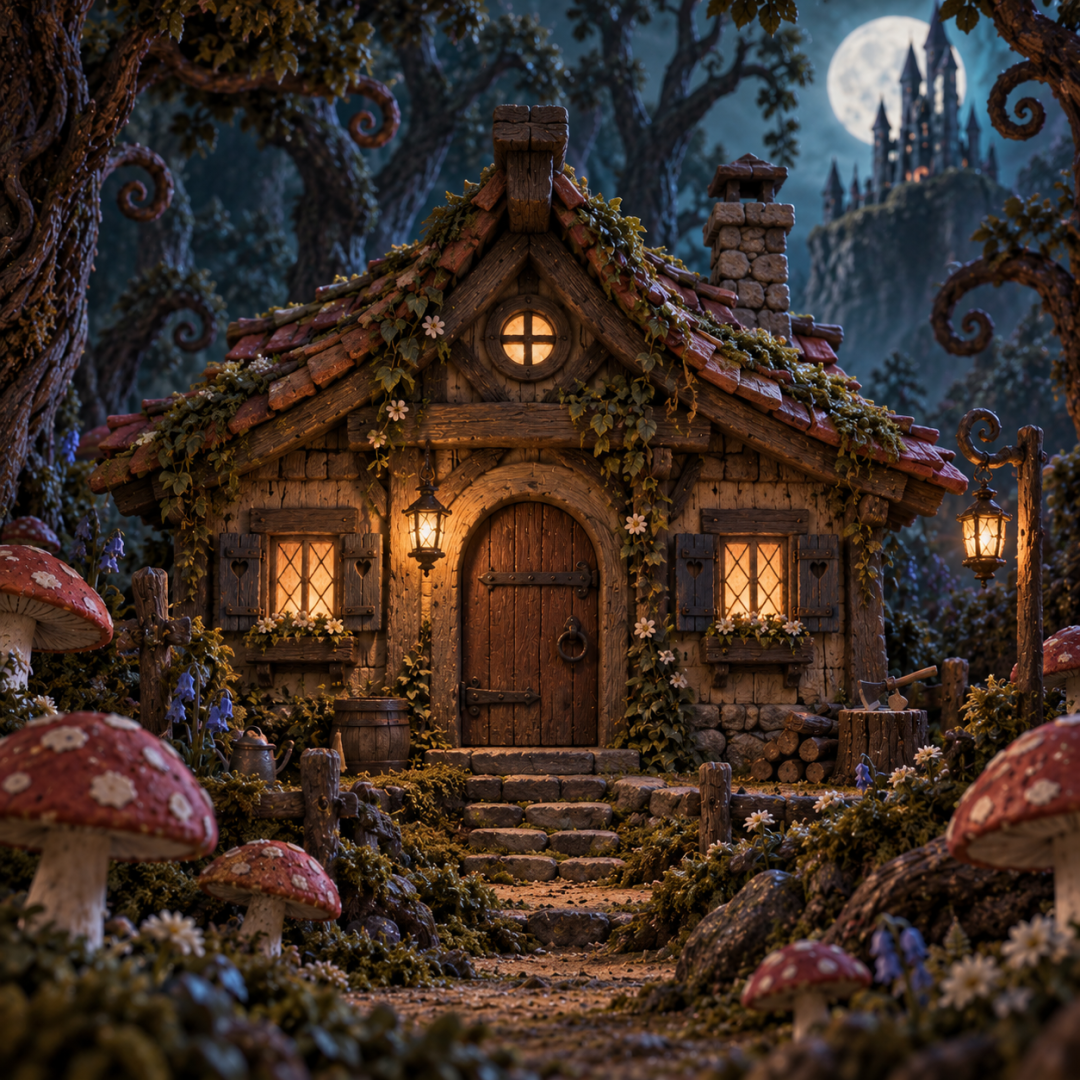
最后一个穿透三维空间测试更是地狱级,我们先让少年出现在下图的小木屋门口,再让少年转身打开正门进入小木屋,最后右转从侧门走出来。
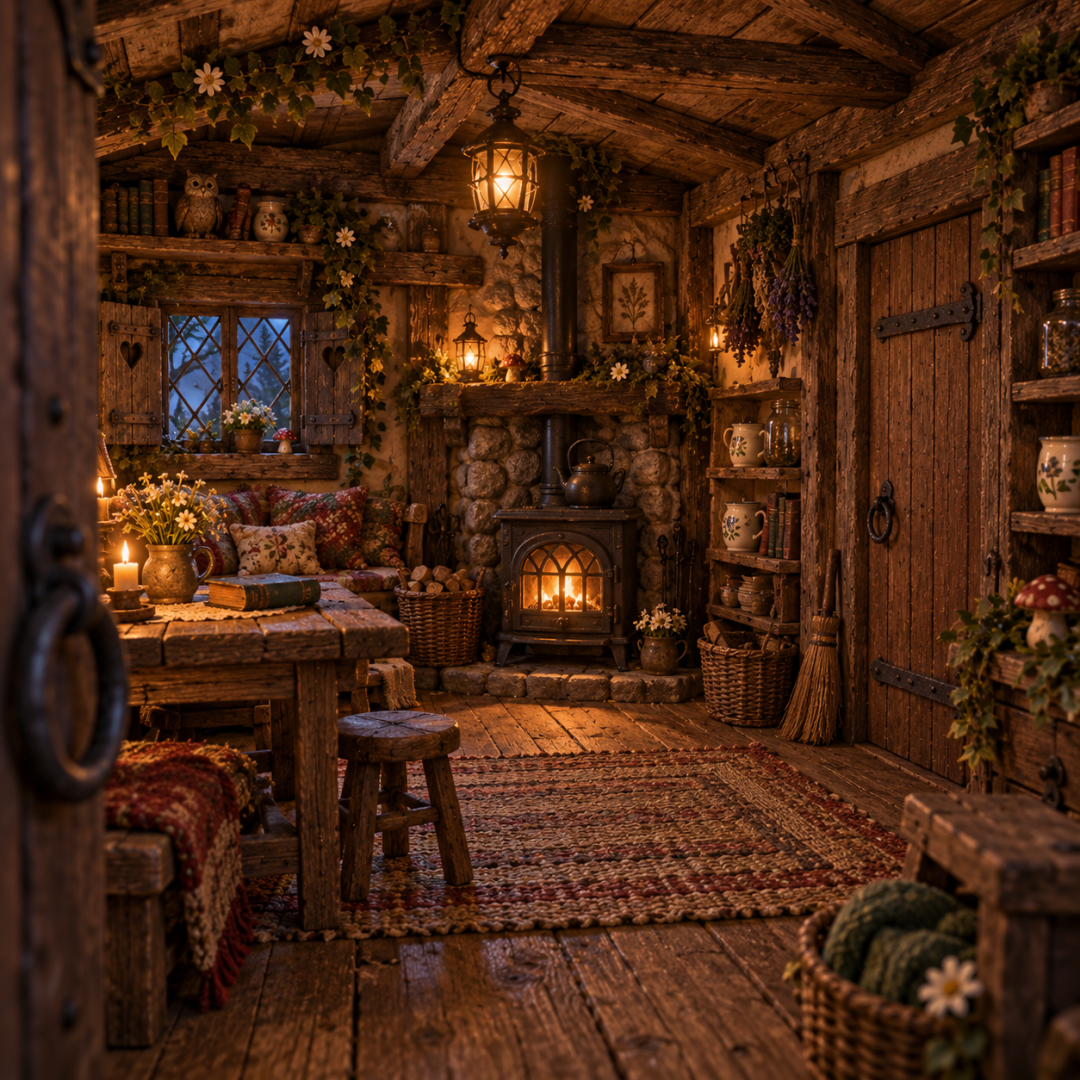
下图是小木屋内从正门看过去的视角,也会提供给模型做参考。
生成结果如下,首先视觉观感就太差,室内走动部分一帧带过,毫无动态可言,更不用说从侧门出来时还变换了镜头,虽然是常规的手法,但不符合我们的基本测试条件,即连续的帧变化。
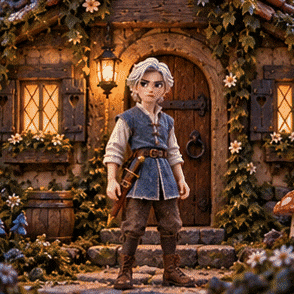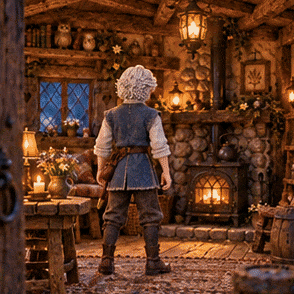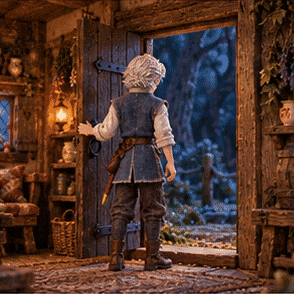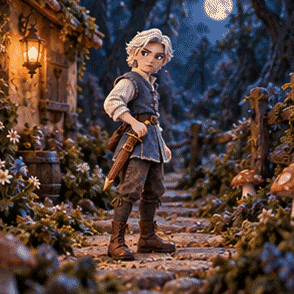
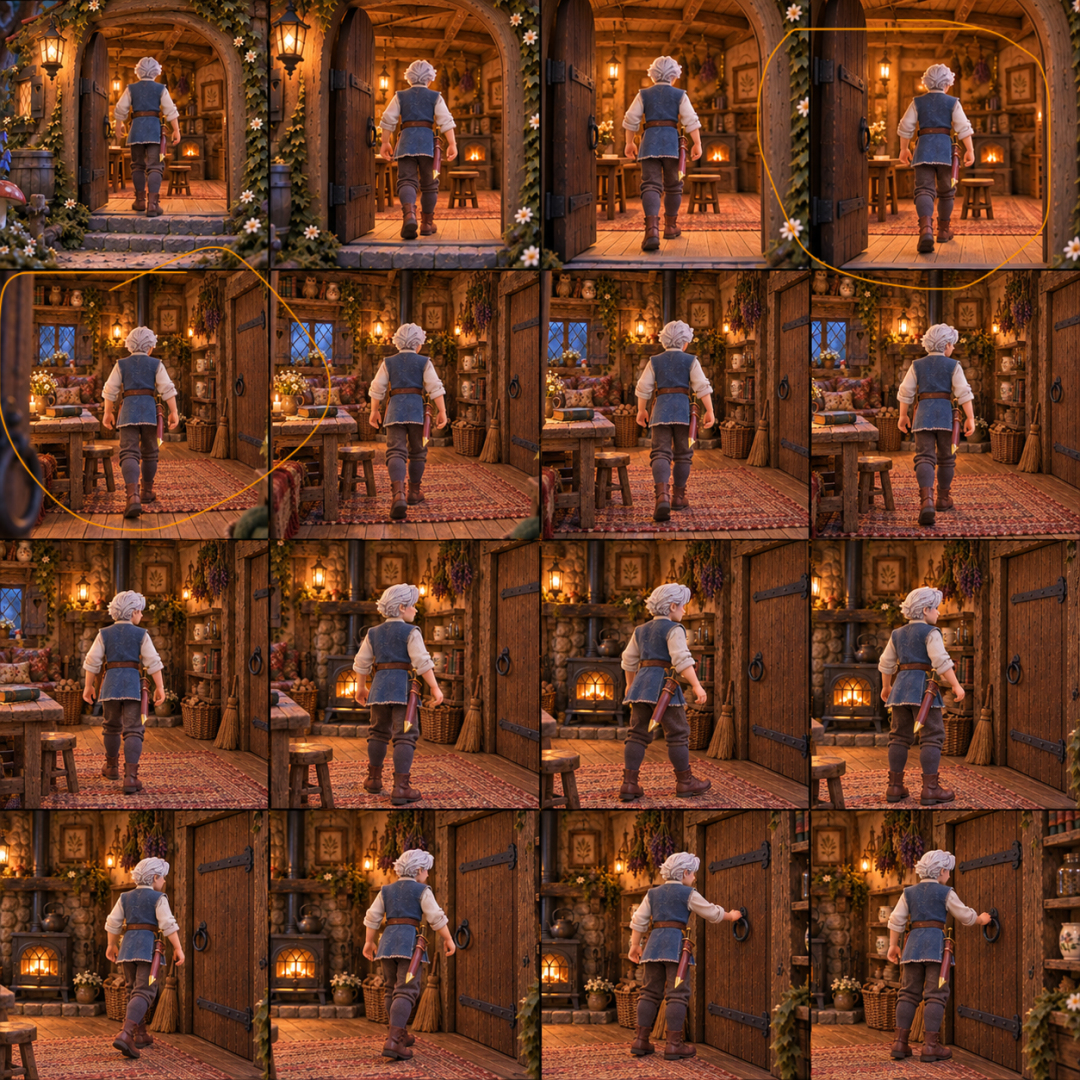
所以,接下来要修改一下设置,和测试踢腿动作时类似,把图片数增加到 48 张,再要求模型采用一镜到底的运镜方式,并把思考强度提高到 xhigh。
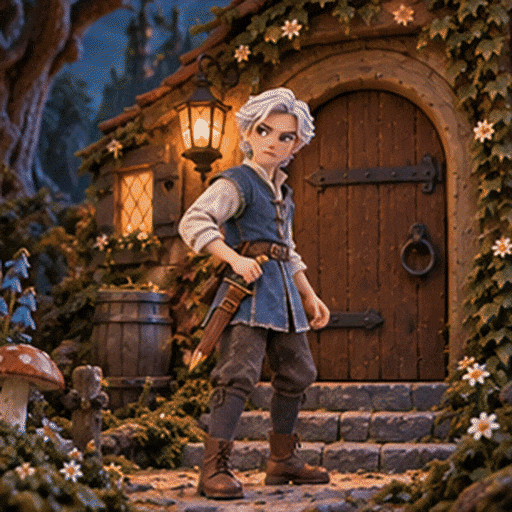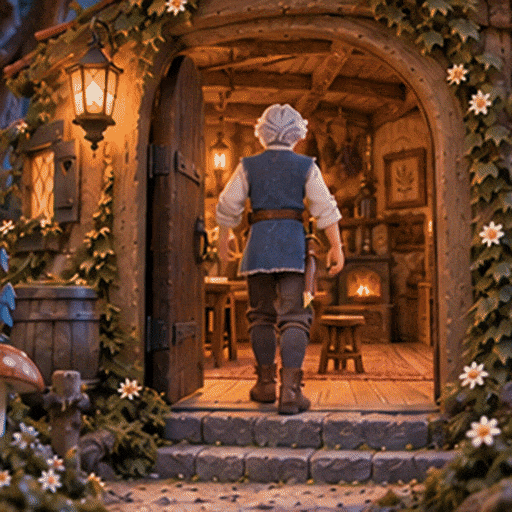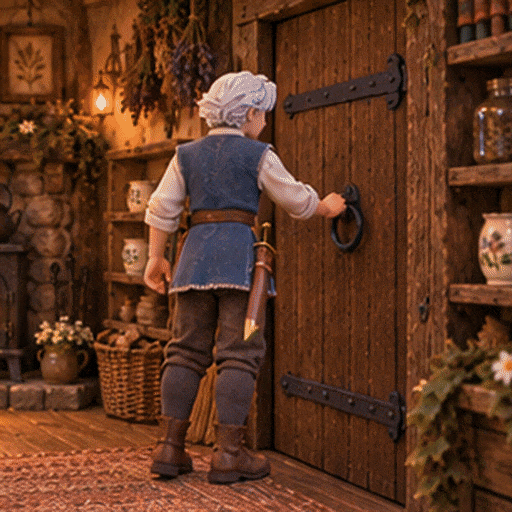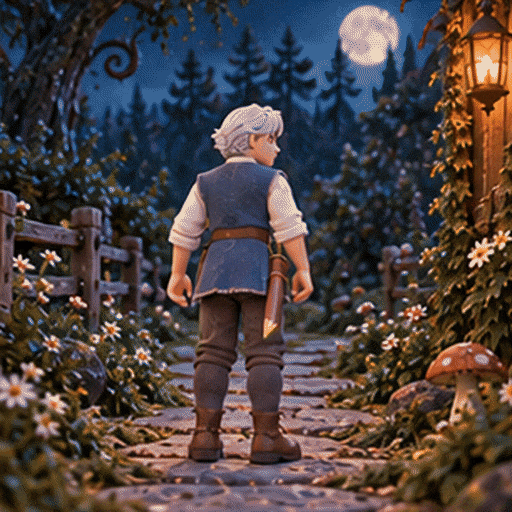
整体还是流畅了很多,至少有了一些定格动画的质感,只是第 20 帧到第 21 帧之间出现明显的跳变和错误,从动图中也能直观感受出来。但就从静态图像的角度来评估帧分解图的精细程度,用来做漫画或分镜设计应该有极大的潜力。
接下来是基础类测试的第四种也就是物理类型,包含两个场景:
- 流体流动;
- 弹性体跳动;
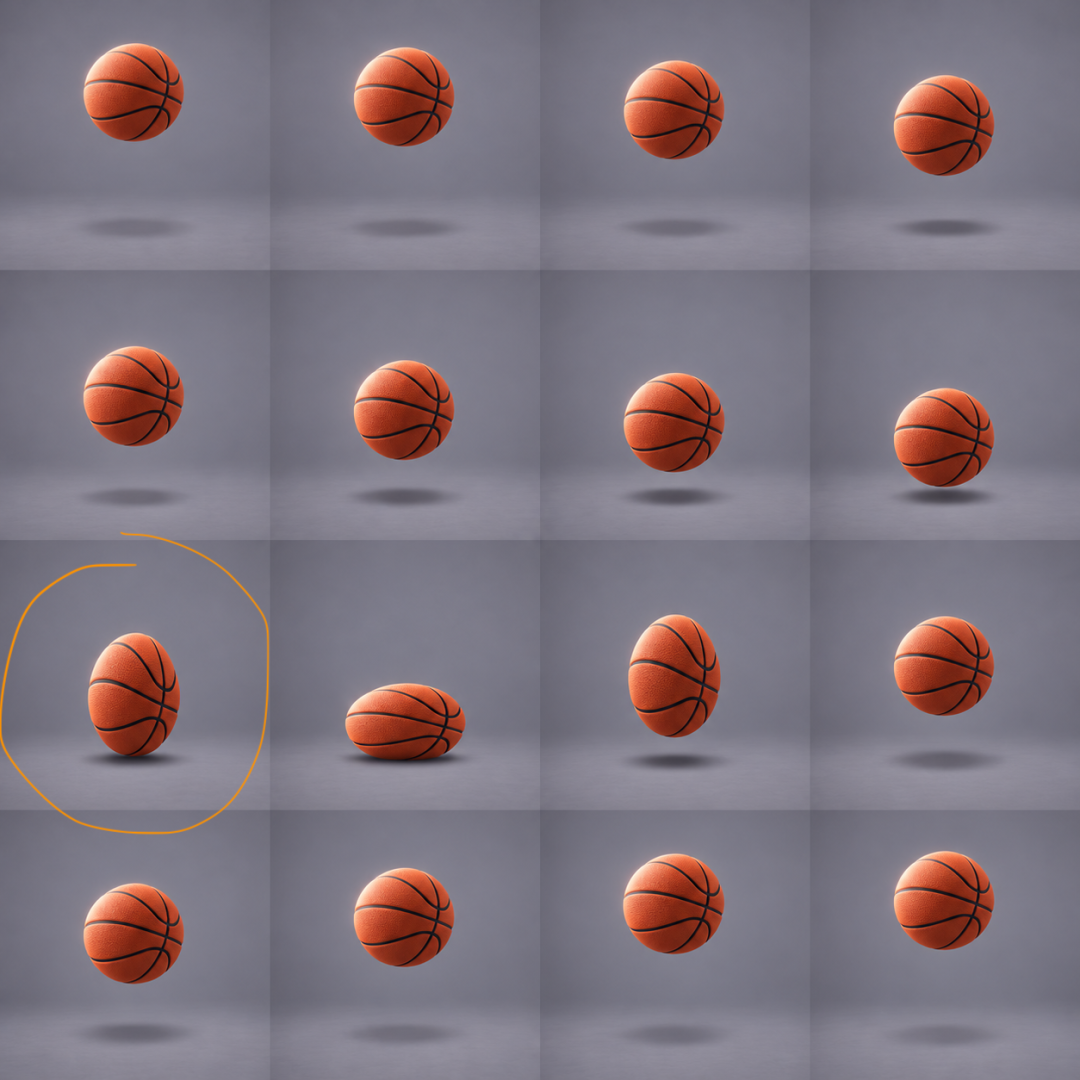
直接看结果即可,水被处理的像凝胶,篮球弹跳时有一瞬间不自然的变形,因为在第 9 帧中篮球在落地前就出现了不符合物理规律的竖直向拉伸。
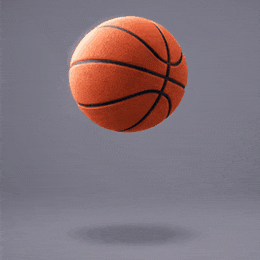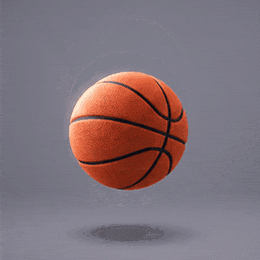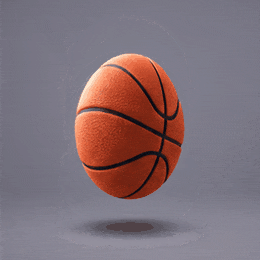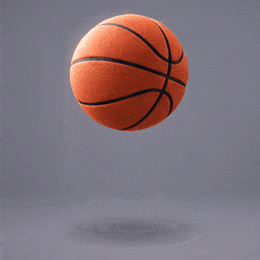
到此,基础类测试基本完成了。
接下来是极限类测试,也就是动图或视频的每一帧都是单独生成的图片,每一秒包含 10 帧,视频时长为 3 到 5 秒,模型思考强度为 xhigh。
在正式开始测试变形金刚案例前,先尝试还原 Higgsfield 展示的参考案例。
这类任务难度会大很多,耗时也长,前面的任务基本都能在 5 分钟内完成,但让 “ 持剑少年原地旋转 360 度 ” 这个任务就执行了 30 分钟,而实现效果则远达不到 Higgsfield 展示案例的丝滑程度。
把画风调整为更简单的线条和纹理后( 皮克斯风格 ),也没有变得更好,甚至过程中出现了很明显的发型变化。
即便把图片数增加,从30张增加到72张,每秒达到了24帧,结果没有变好,反而更差( 为降低难度刻意让模型生成分辨率更低的图像,但模型没有遵循,而是先生成高清图再压缩 )。
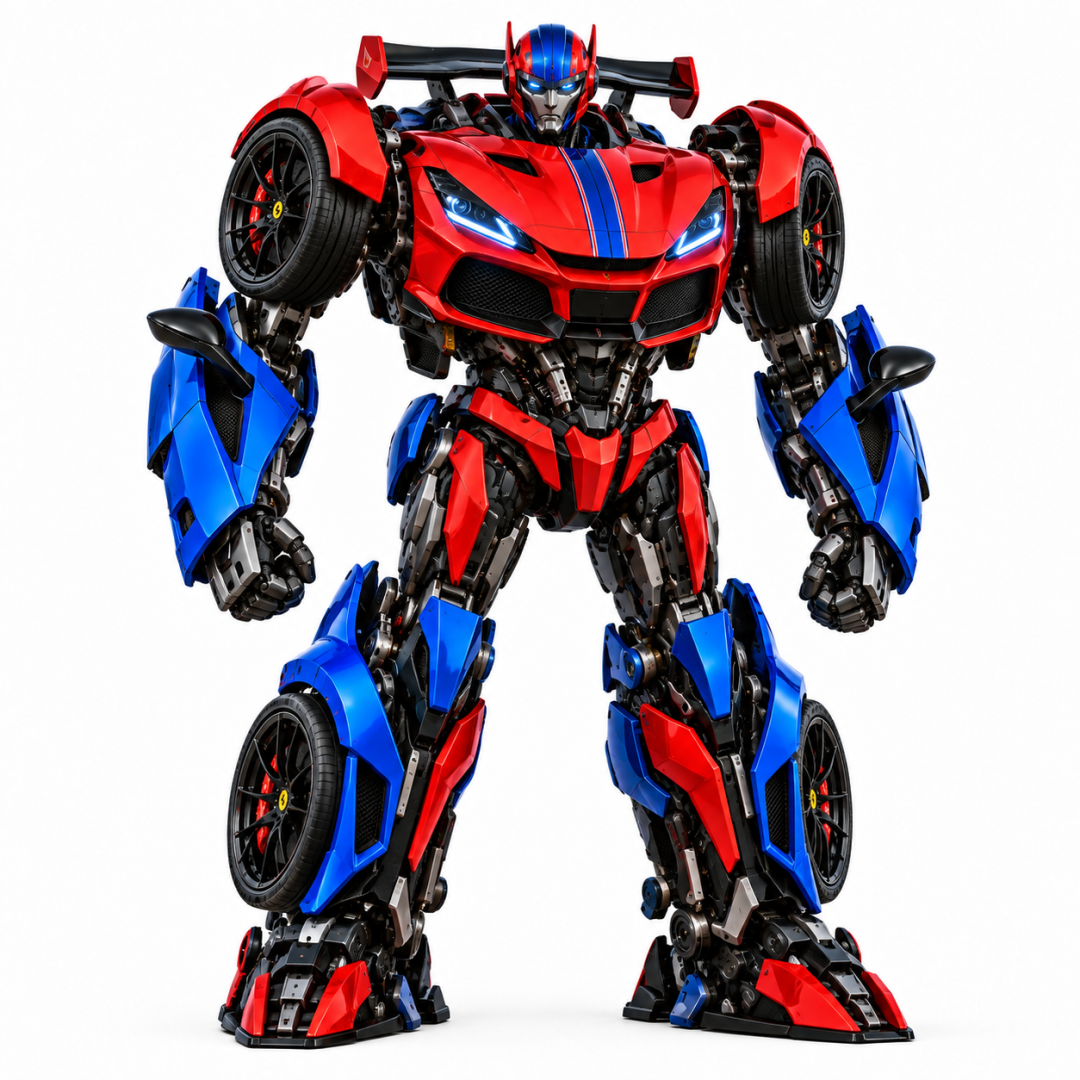
暂时还不知道怎么继续优化输入条件,只能先换到变形金刚这个案例。在这个案例中,我们要求模型呈现从跑车到变形金刚的动态过程。
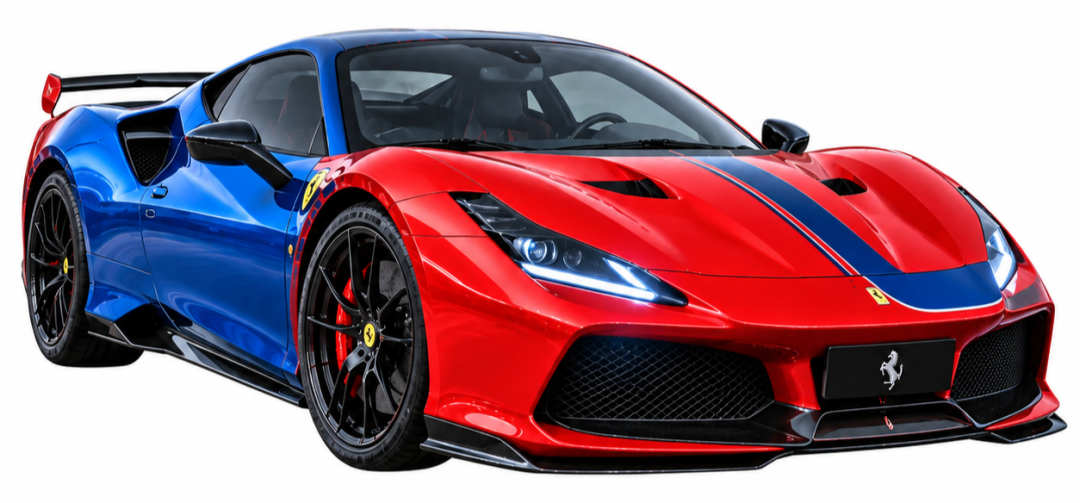
生成结果如下,变形金刚的变形过程做得倒是不错,整体没有严重的随机抖动。为了增加难度,不让模型走捷径,也要求它严格遵循机械变形的物理特性,至少前半部分是有遵循的,后半部分开始用流体性质的变形手法,这也是扩散模型机制绕过物理约束的常见手段了。
当然,最终形态距离提供的参考图还有一定距离。
测评结束!
总体来看,在基础类测试中,GPT-Image 2.5基本只擅长处理透明或纯色背景下单主体的简单动作和简单运镜,稍微增加一些难度,比如动作多一点,运镜刁钻一点,基本都会翻车,比如随机抖动,还很容易触发一些低级的错误,比如人体的生物准确性。
在极限类测试中,由于无法实现最简单的旋转动作,即便变形金刚案例的效果不算翻车,也无法保证其发挥是稳定的。
所以,综合观感其实是比较失望的,毕竟网上的案例太过惊艳,提高了期待值,而我们既没能还原已有的案例,也无法在更难的场景中收获足够的惊喜。
虽然不排除大量使用Flare模型而没有使用Sunburst的原因,但我们也简单尝试了在Lovart里先用GPT-Image 2.5 Sunburst Max生成帧分解图,再用ChatGPT Work切分和合成gif的做法,实际结果也是没那么完美,比如下图中,少年在旋转过程中会有明显的头部摆动。
最重要的是,即便最终能输出完美的结果,这也是GPT-Image 2.5和GPT-6 Astra合力的结果,不完全是GPT-Image 2.5的功劳。GPT-6 Astra会在执行过程中持续检查画面连续性,并修复有错误的部分图片。
当然,GPT-Image 2.5仍然达到了里程碑式的进步,毕竟这些基础动效过去需要用专业动画软件才能实现,这背后其实反映了图像生成工作流中最关心的指标即抽卡成功率——预计将会大幅提升,直接对应生产成本的下降。
还有一个隐含的优势是,GPT-Image 2.5在连续生成30到72张图像后,图像质量仍然保持一定水准,没有出现其它模型常见的多轮编辑后的大量模糊、噪点、线条扭曲等图片缺陷( 甚至撑不到10轮编辑 ),从而可以更好支持深度工作。当然这一点没有经过直接验证,大家可以亲自试试。
GPT-Image 2.5发布之后,预计未来的图像模型竞争焦点,将是在长流程、多步骤、强约束任务中的稳定性和成本效益。
作者:知危
来源:知危
扫一扫 微信咨询

商务合作 联系我们
 微信扫一扫